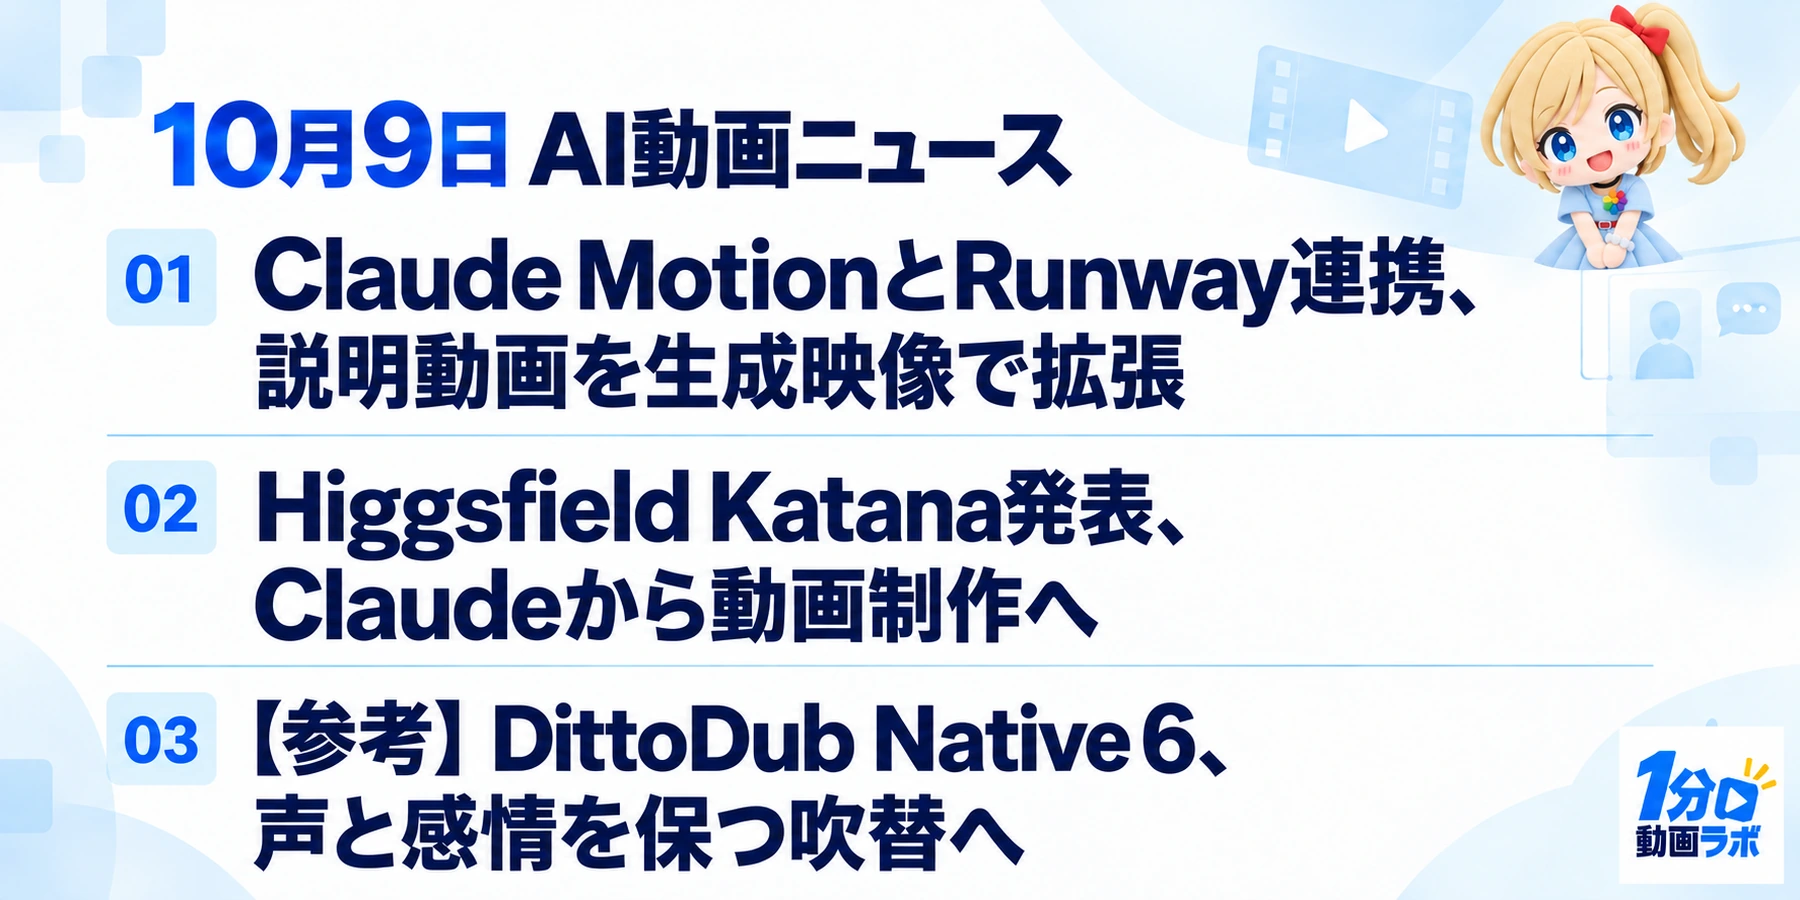
Claude Motion und Runway verbunden: Erklärvideos durch generierte Bilder erweitern
Runway hat am 8. Oktober angekündigt, Startpartner für „Claude Motion“ von Anthropic zu sein. Claude Motion erstellt kurze animierte Erklärvideos aus vorhandenen Texten, Diagrammen, Formen und Bildern und wird als Beta für Team und Enterprise angeboten.
In Claude erstellte Animationen lassen sich nach Runway exportieren, mit generierten Videos, Bildern und Audio ergänzen und szenenweise bearbeiten. Neben dem MP4-Export werden auch auf die Zielplattform abgestimmte Ausgaben wie Hochformat und Quadrat vorgestellt.
Quellen, Bilder und Beispiele
Higgsfield Katana angekündigt: von Claude zur Videoproduktion
In einem offiziellen Instagram-Beitrag vom 8. Oktober hat Higgsfield „Katana“ vorgestellt, ein Bearbeitungstool mit „Claude Motion“. Laut Beitrag ist es von Claude aus über Higgsfield MCP nutzbar. MCP ist ein Verfahren, um KI-Assistenten mit externen Tools zu verbinden.
Als Anwendungsfall werden unter anderem Produktankündigungsvideos genannt. Geprüft werden konnte diesmal der offizielle Vorstellungsbeitrag; detaillierte separate Preise, Nutzungskontingente und die Produktionsgenauigkeit auf Japanisch ließen sich für Katana nicht bestätigen.
Quellen, Bilder und Beispiele
[Hintergrund] DittoDub Native 6: Synchronisation mit erhaltener Stimme und Emotion
DittoDubs neues Synchronisationsmodell „Native 6“ ist zum Standardmodell für neue Uploads geworden. Der am 9. Oktober geprüfte offizielle Artikel nennt die Unterstützung von 126 Sprachen. Da das Datum des Artikels relativ angezeigt wird, behandeln wir ihn als Hinweis zu verfügbaren Funktionen und nicht als neue Ankündigung vom 9. Oktober.
Laut Unternehmen verbessert das Modell gegenüber seinem Vorgänger die Ähnlichkeit der Sprecherstimme um 12 %, die emotionale Ähnlichkeit um 21 % und die Aussprache ressourcenarmer Sprachen um 38 %. Dies sind Messwerte des Unternehmens, keine Garantie derselben Verbesserung für jedes Video und jede Sprache.
Quellen, Bilder und Beispiele
Informationsstand: 9. Oktober 2026. Die Vorschläge für den Einsatz in der Produktion sind Überlegungen der Redaktion. Bilder und Videos sind in den verlinkten Originalartikeln zu sehen.