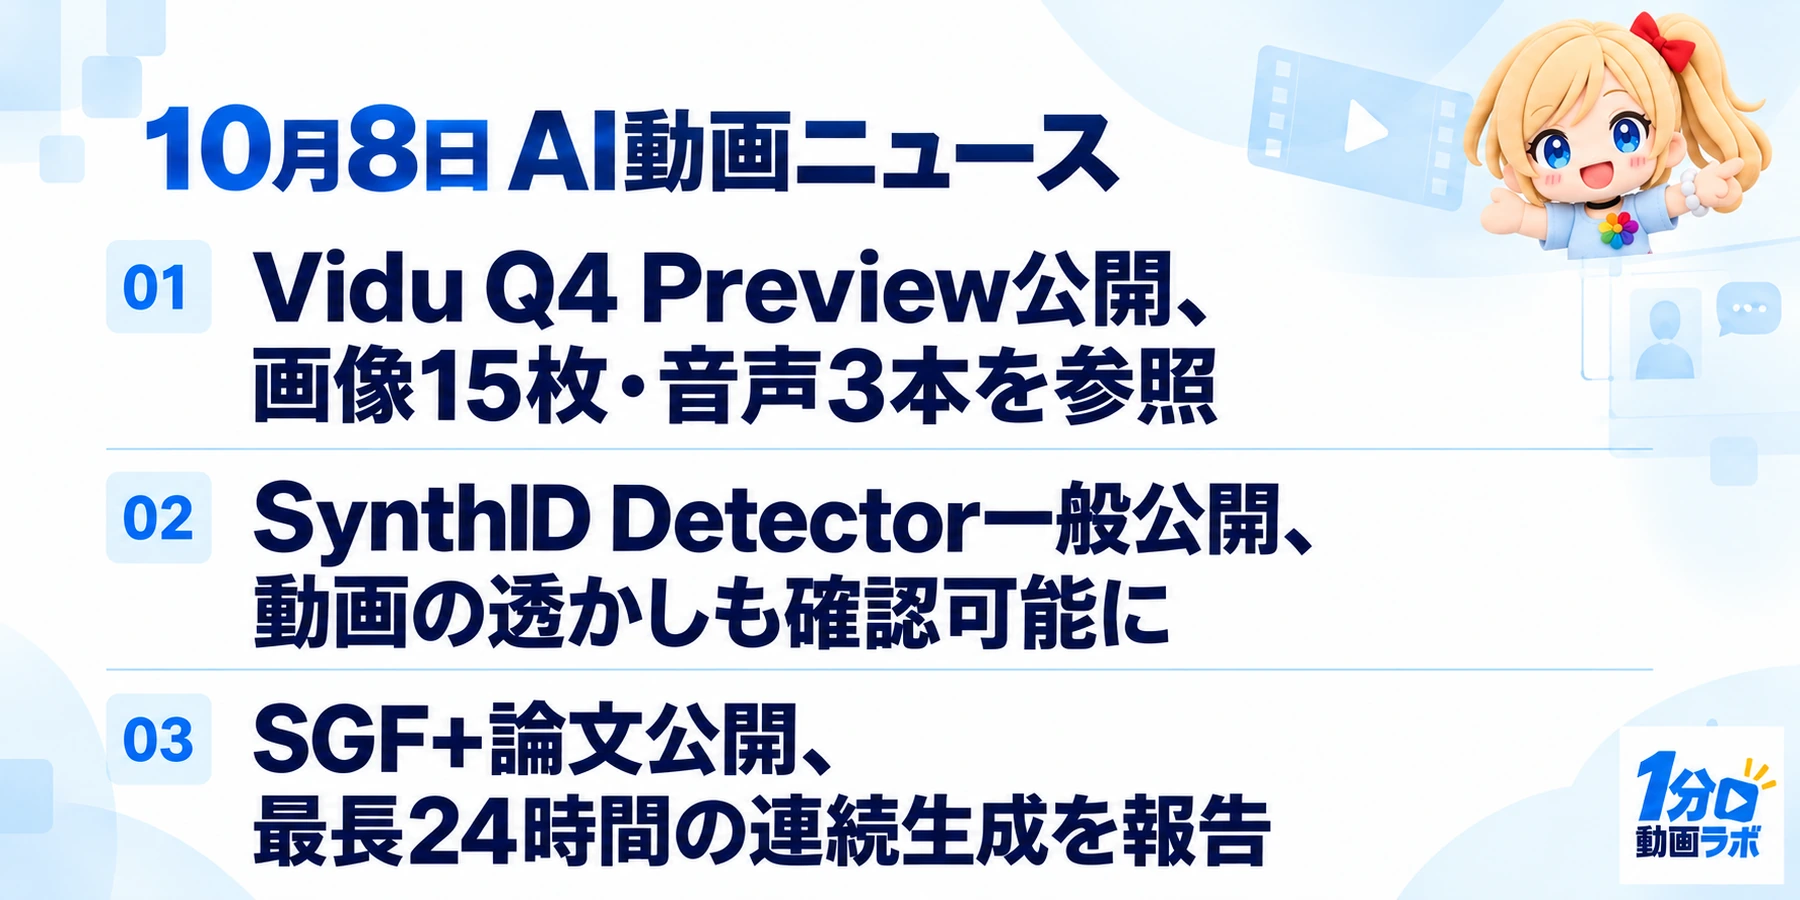
Vidu Q4 Preview veröffentlicht: bis zu 15 Bilder und drei Audiodateien als Referenzen
Shengshu Technology hat am 7. Oktober das Vidu-Modell der nächsten Generation „Q4 Preview“ im Web und über eine API veröffentlicht. Der Zeitpunkt der Ankündigung entspricht den frühen Morgenstunden des 8. Oktober in Japan. Unterstützt werden bis zu 15 Bildreferenzen und drei Audioreferenzen; angekündigt werden Ausgaben in 2K und 4K mit 10 Bit.
Die bessere Abstimmung von Gesichtsausdruck, Stimme und Bewegung sowie verbesserte Kameraführung sind Angaben des Unternehmens. Die Ankündigung nennt einen Einführungspreis ab 0,014 US-Dollar pro Sekunde, weist aber darauf hin, dass endgültige Preise, verfügbare Auflösungen und Funktionen je nach Plan und Region variieren. Der gleiche Stückpreis gilt nicht für alle Ausgaben.
Quellen, Bilder und Beispiele
SynthID Detector allgemein verfügbar: auch Wasserzeichen in Videos lassen sich prüfen
Google hat am 7. Oktober angekündigt, SynthID Detector weltweit auf Englisch allgemein verfügbar zu machen. Das Tool prüft Bild-, Video- und Audiodateien auf unsichtbare Wasserzeichen, die von der KI von Google und Partnern eingefügt wurden.
Die offizielle Ankündigung nennt OpenAI, NVIDIA und Kakao als Partner; die Unterstützung für Apple ist als bald verfügbar angegeben. Da das Tool nach unterstützten Wasserzeichen sucht, beweist ein fehlender Treffer nicht, dass die Datei von einem Menschen erstellt wurde.
Quellen, Bilder und Beispiele
SGF+-Fachartikel veröffentlicht: kontinuierliche Generierung von bis zu 24 Stunden berichtet
Die Videogenerierungsforschung „SGF+“ wurde am 7. Oktober um 17:09 UTC bei arXiv eingereicht, entsprechend den frühen Morgenstunden des 8. Oktober in Japan. Der Ansatz verlängert Videos durch die nacheinander erfolgende Generierung kurzer Abschnitte und schlägt vor, den Prozess zum Speichern bisherigen Kontexts und den zum Erstellen des nächsten Abschnitts getrennt zu trainieren.
Die Autoren berichten, nach einem Training mit fünfsekündigen Generierungen bis zu 24 Stunden kontinuierlich generiert zu haben, ohne zusätzliches Training mit langen Videos. Das ist ein Forschungsergebnis und keine Produktspezifikation, die eine konsistente Handlung oder konsistente Personen über ein vollständiges 24-Stunden-Werk garantiert.
Quellen, Bilder und Beispiele
Informationsstand: 8. Oktober 2026. Die Vorschläge für den Einsatz in der Produktion sind Überlegungen der Redaktion. Bilder und Videos sind in den verlinkten Originalartikeln zu sehen.