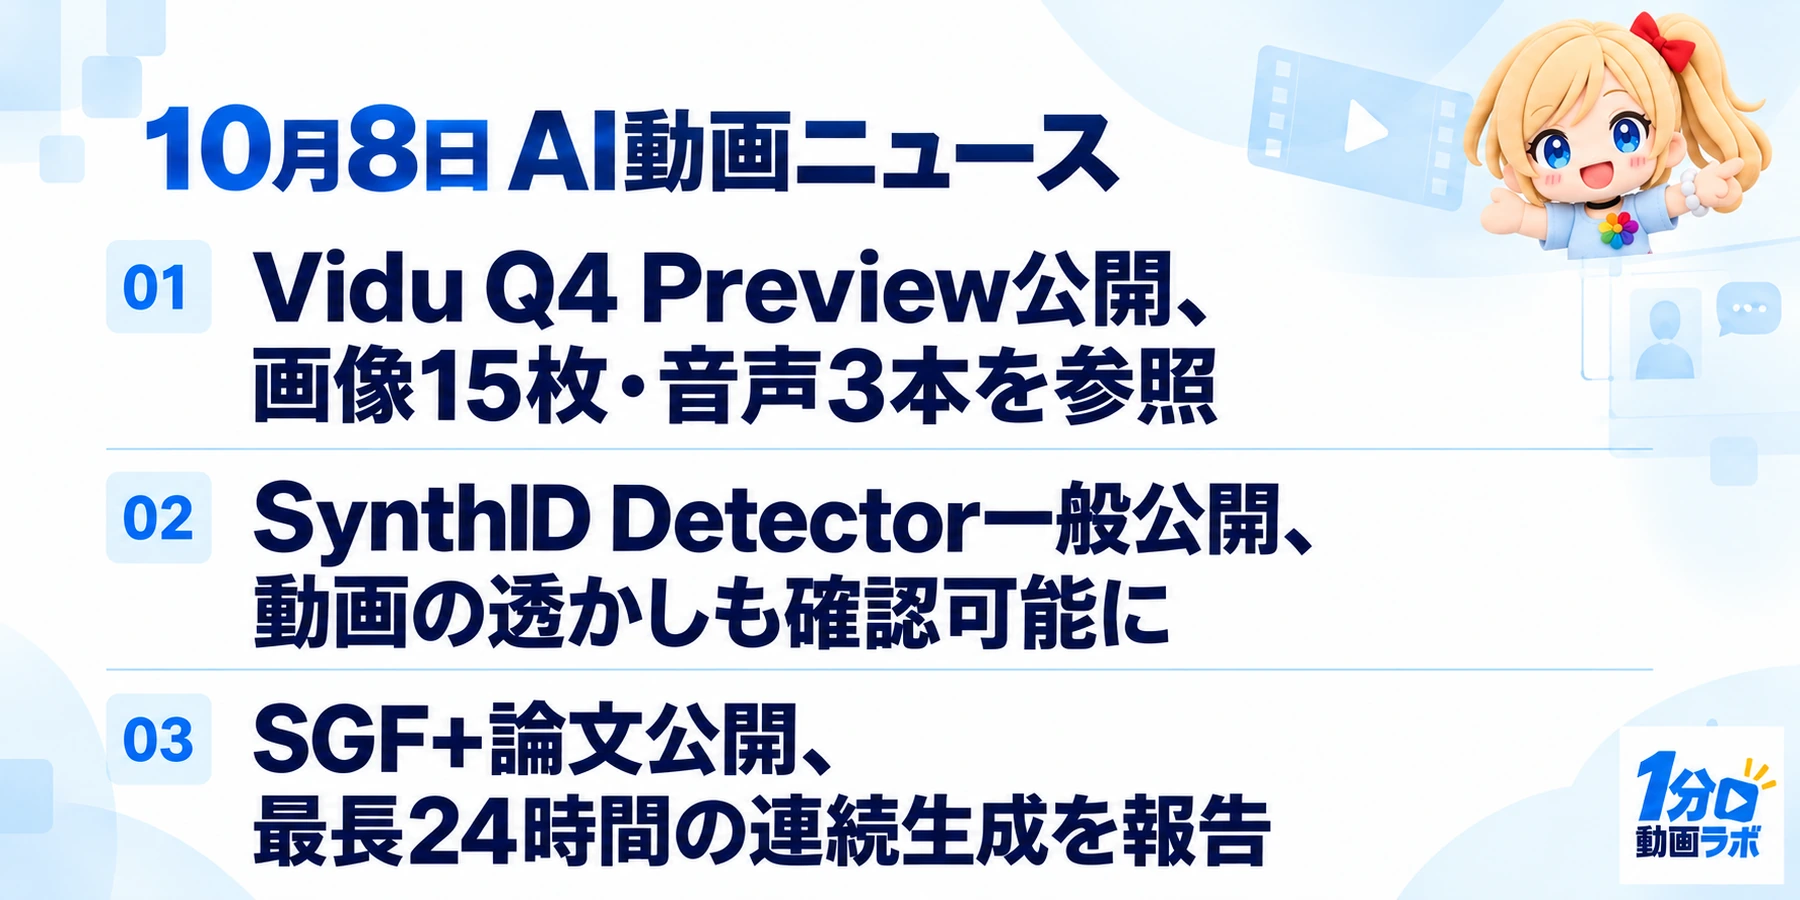
Vidu Q4 Preview est publié : jusqu’à quinze images et trois fichiers audio de référence
Le 7 octobre, Shengshu Technology a publié « Q4 Preview », le modèle de nouvelle génération de Vidu, sur le Web et via une API. L’heure de l’annonce correspond aux premières heures du 8 octobre au Japon. Jusqu’à quinze images et trois fichiers audio peuvent servir de références ; des sorties 2K et 4K en 10 bits sont annoncées.
La coordination des expressions, de la voix et des mouvements ainsi que l’amélioration des mouvements de caméra sont décrites par l’entreprise. L’annonce indique un tarif de lancement à partir de 0,014 dollar par seconde, mais précise que le tarif final, les résolutions et les fonctions disponibles varient selon le forfait et la région. Le même prix unitaire ne s’applique pas à toutes les sorties.
Sources, images et exemples
SynthID Detector s’ouvre au public et permet aussi de vérifier les filigranes vidéo
Le 7 octobre, Google a annoncé l’ouverture générale de SynthID Detector en anglais dans le monde entier. Cet outil examine des fichiers image, vidéo et audio pour y rechercher les filigranes invisibles ajoutés par les IA de Google et de ses partenaires.
L’annonce officielle cite OpenAI, NVIDIA et Kakao parmi les partenaires, et indique une prise en charge prochaine d’Apple. Le système recherche des filigranes compatibles : leur absence ne prouve donc pas qu’un fichier a été créé par un humain.
Sources, images et exemples
Publication de l’article SGF+ : jusqu’à vingt-quatre heures de génération continue rapportées
La recherche en génération vidéo « SGF+ » a été soumise à arXiv le 7 octobre à 17:09 UTC, soit au début du 8 octobre au Japon. Elle prolonge la vidéo en générant successivement de courts segments et propose de séparer l’entraînement du processus qui mémorise le contexte passé de celui qui crée les images suivantes.
Les auteurs rapportent avoir atteint jusqu’à vingt-quatre heures de génération continue à partir d’un entraînement sur des générations de cinq secondes, sans entraînement complémentaire avec de longues vidéos. Il s’agit d’un résultat expérimental de recherche, et non d’une spécification de produit garantissant la cohérence du récit ou des personnages sur une œuvre entière de vingt-quatre heures.
Sources, images et exemples
Informations à jour au 8 octobre 2026. Les pistes d’utilisation en production sont les réflexions de la rédaction. Les images et vidéos sont disponibles dans les articles originaux accessibles par les liens.